Spark
- tags: Bigdata
Spark 编程语言选择⌗
毋庸置疑,Python 应该是最简单也是大部分的选择,但是如果有依赖那么将要付出额外的心智负担(Spark 管理 Python 依赖)。 JVM 语言的依赖组织方式则具有天然的优势,可以将依赖(排除 Spark 生态之后)都 bundle 进 Jar 包里。 其中 Scala 兼具简单和 JVM 的优势,但是它「不流行」。
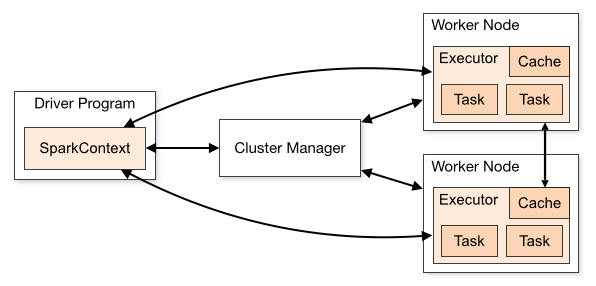
Spark Driver & Executor⌗
- Driver 执行 spark-commit 客户端,创建
SparkContext执行main函数。 - Executor Spark Worker 上的线程
See also:
Spark 代码执行⌗
我在配置 Spark 的时候就在好奇,从观察上看部分代码应该是执行在 Driver 上部分代码会执行在 Executer,这让我很好奇。 但是我通过学习 Spark RDD 学习到了一些知识。
以下代码是在 Executor 上执行的:
- Transformations 和 Actions 是执行在 Spark 集群的。
- 传递给 Transformations 和 Actions 的闭包函数也是执行在 Spark 集群上的。
其他额外的代码都是执行在 Driver 上的,所以想要在 Driver 打印日志需要上使用 collect:
rdd.collect().foreach(println)
collect 可能会导致 Driver 内存爆掉,可以使用 take:
rd.take(100).foreach(println)
所以在这就带来在闭包中共享变量的问题,参见 Spark 共享变量。
Spark 编程抽象⌗
Spark RDD⌗
集合并行化⌗
val data = Array(1, 2, 3, 4, 5)
val distData = sc.parallelize(data)
外部数据集⌗
- 输入源支持支持 Hadoop 支持的任何存储源,包括:本地文件系统、HDFS、Cassandra、HBase、Amazaon S3 等
- 输入格式支持:文本文件、SequenceFiles 和任何其他 Hadoop InputFormat
如果是本地文件系统,则文件需要存在与所有 Worker 节点上。
Spark Transformations vs Actions⌗
Spark 支持两种操作类型:
- transformations:从现有数据集创建新的数据集,比如
map。 - actions:在数据集上进行运算然后返回值给 driver,比如
reduce。
Spark Transformations 懒执行⌗
所有的 Spark transformations 会记住应用的基础数据集,只要在需要将结果返回给 driver 的时候才进行计算。
比如,我们可以感知到一个数据集(dataset)通过 map 创建,将会被 reduce 使用并返回 reduce 的结果给 driver 而不是一个映射过(mapped)的大数据集。
Spark transformations 重复计算⌗
默认情况下,每一次在一个 RDD 上运行 action Spark 都可能会进行重新计算,这时候可以使用 persist 缓存一个 RDD 到内存中。 下一次查询将会被加速,同时 Spark 支持存储到磁盘或者跨多节点复制(replicated)。
Spark 共享变量⌗
Spark 支持两种共享变量的方式:
- Broadcast Variables
- Accumulators
设置 Spark Python 版本⌗
export PYSPARK_DRIVER_PYTHON=python # Do not set in cluster modes.
export PYSPARK_PYTHON=./environment/bin/python # Executor
上面 environment 是提交的时候需要在 --archives 缀上的:
spark-submit --archives pyspark_conda_env.tar.gz#environment app.py
Note that
PYSPARK_DRIVER_PYTHONabove should not be set for cluster modes in YARN or Kubernetes.
Spark 管理 Python 依赖⌗
YARN⌗
支持 --archives 参数上传打包好的环境信息,主要三种方式:
- PySpark 原生特性,
--py-files支持 zip 和 egg 格式,但是不支持 whl - Python vendor package
See alos: Python Package Management
Standalone cluster⌗
可以借助上面的 Python 包管理机制,将打包好的环境在各个节点进行同步。假设将 conda-pack 解压到 /opt/conda-envs/test,可以通过在 Spark 任务脚本最上方通过 PYSPARK_PYTHON 指定解释器:
import os

os.environ['PYSPARK_PYTHON'] = '/opt/conda-envs/test'

conf = {}
sc = SparkContext(conf=conf)
Spark Hive 表问题汇总⌗
Spark 2.3 之后读取 Hive Orc 字段全是 null 或者无法过滤⌗
主要是因为 Orc 文件在 Hive 中存储的时候是大小写敏感的 Schema。 通过如下配置关闭 2.3 之后启用的选项:
spark.sql.hive.convertMetastoreOrc=false
但是启用这个会导致写 Hive Orc 表的时候报错:
[2021-11-20 08:22:26,500] {spark_submit.py:523} INFO - : java.lang.NoSuchMethodException: org.apache.hadoop.hive.ql.metadata.Hive.loadPartition(org.apache.hadoop.fs.Path, java.lang.String, java.util.Map, boolean, boolean, boolean, boolean, boolean, boolean)
只能在读指定表的时候动态设置:
spark.conf.set("spark.sql.hive.convertMetastoreOrc", False)
更多坑可以看 Upgrading Guide⌗
Spark 写入的 Hive Orc 表但是旧版 Hive 无法读取⌗
# 解决写入 Orc 表但是 Hive 无法读取的问题
spark.sql.orc.impl=hive